

在地鐵里丟了一個(gè)包,AI能幫著找到嗎?
放在過去,這件事兒沒那么簡單。
傳統(tǒng)視覺AI通常有一套固定流程:你得先準(zhǔn)備大量圖片、標(biāo)注、訓(xùn)練,告訴機(jī)器要識(shí)別什么,最后得到一個(gè)專門識(shí)別這類目標(biāo)的模型,但誰也做不到提前就知道乘客丟的是什么東西。
那么,問題就來了,人不可能一開始就把所有東西都教給AI。
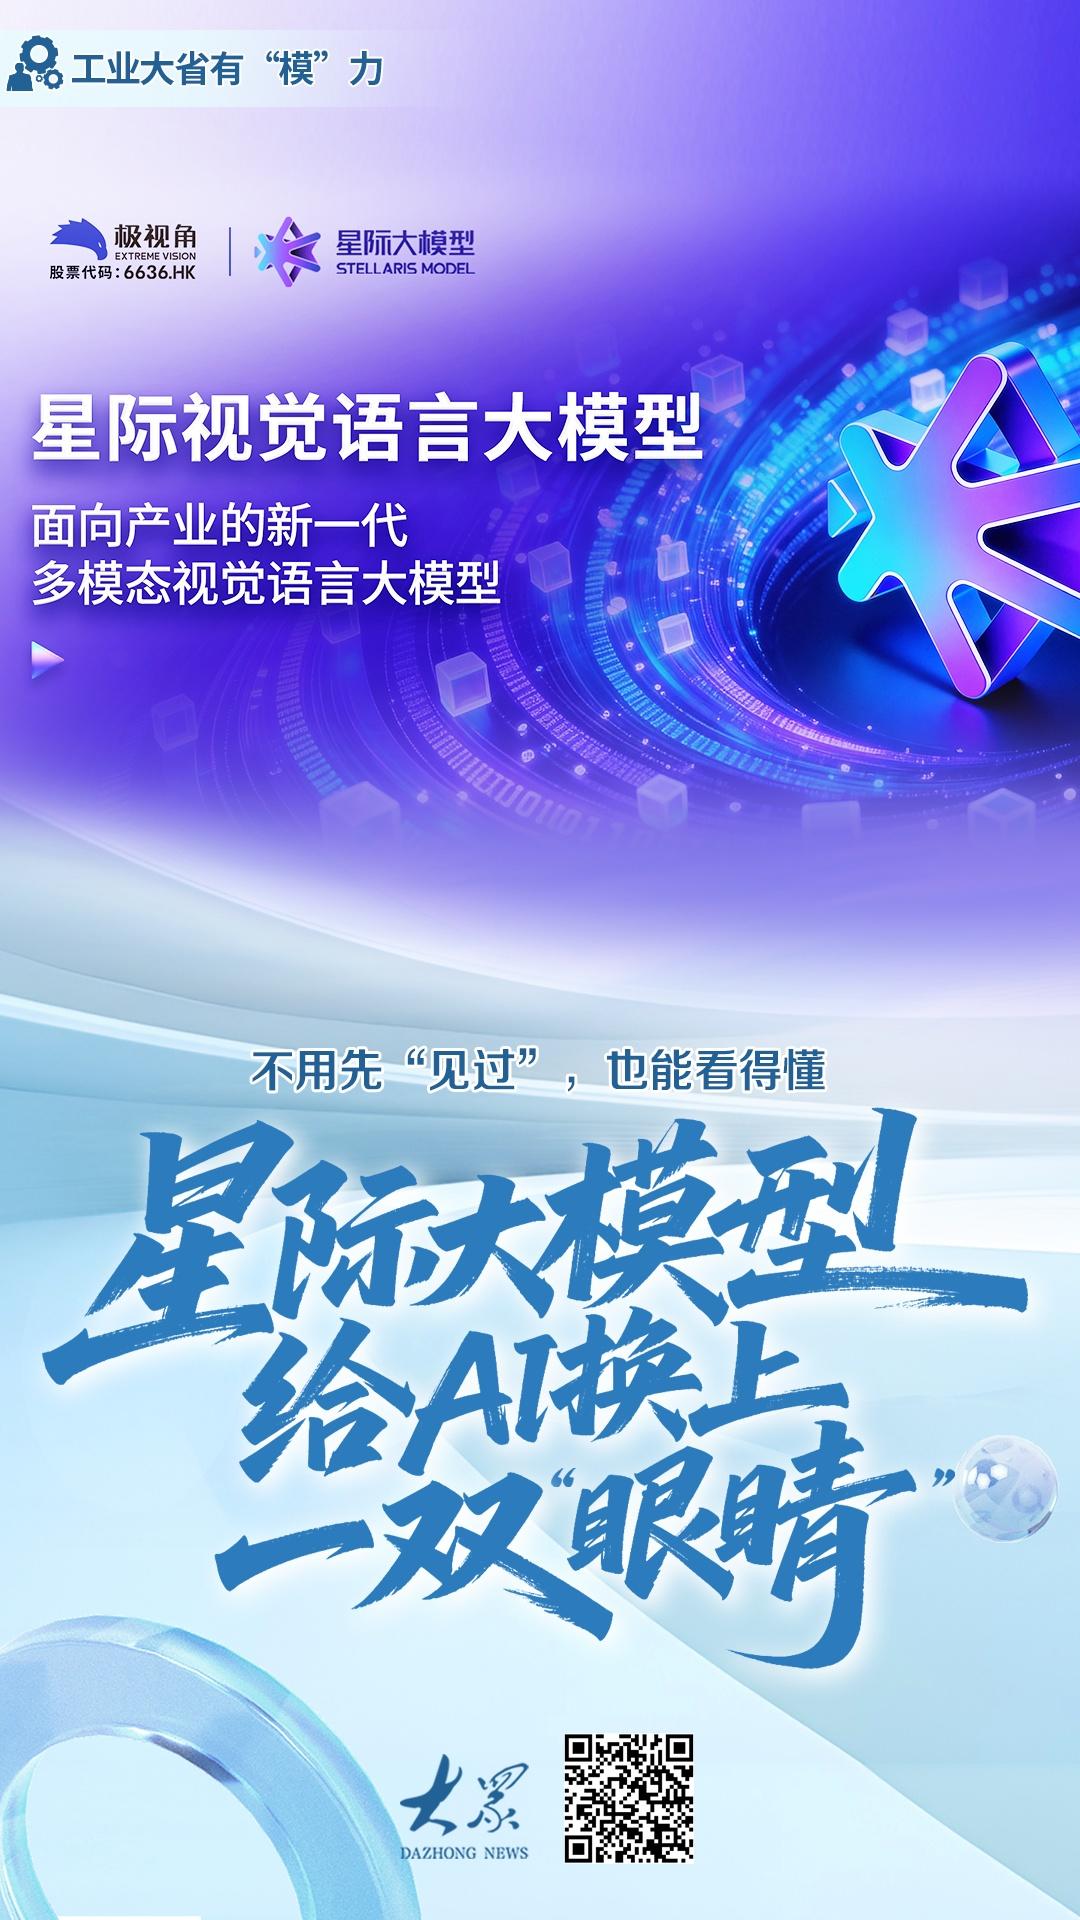
山東極視角科技股份有限公司聯(lián)合創(chuàng)始人、總裁陳碩舉了地鐵失物招領(lǐng)的例子。“大模型的好處,就是一些可能沒有見過的東西,通過語言描述,它也能做到識(shí)別。”陳碩說,這正是星際視覺語言大模型Stellaris-VL想解決的問題。
它不只是讓機(jī)器“看見”,而是讓機(jī)器開始理解人到底想讓它看到的各種目標(biāo)。
把視覺和語言放到同一模型
過去十多年,機(jī)器視覺已經(jīng)進(jìn)入大量工業(yè)場(chǎng)景。工人有沒有戴安全帽、產(chǎn)品表面有沒有瑕疵、設(shè)備是不是冒煙,這類任務(wù)都已經(jīng)不陌生。
但傳統(tǒng)視覺算法往往很“專一”。識(shí)別安全帽是一套模型,檢測(cè)某種產(chǎn)品缺陷又是一套模型,一旦目標(biāo)換了、環(huán)境變了,往往需要重新準(zhǔn)備數(shù)據(jù)、重新標(biāo)注、重新訓(xùn)練。真實(shí)的生產(chǎn)現(xiàn)場(chǎng),卻不會(huì)永遠(yuǎn)按照事先準(zhǔn)備好的“題庫”出題。
地鐵施工中的“工器具出清”就是一個(gè)很典型的例子。施工人員進(jìn)場(chǎng)前,要把人員、工具、設(shè)備擺好拍照。施工結(jié)束后,再拍一張,比對(duì)兩張照片看人是不是都出來了,工具是不是都帶走了。
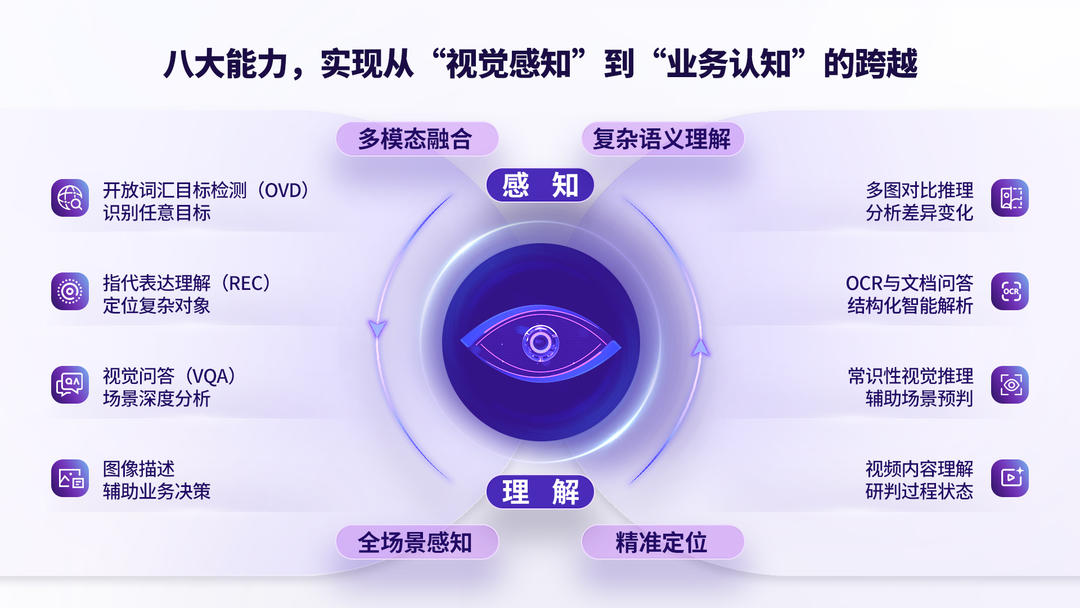
但難點(diǎn)在于,工器具種類可能非常多,擺放方式、拍攝角度也一直變化。這不是簡單的“找不同”,因?yàn)闄C(jī)器需要知道照片里分別是什么,再理解兩張圖之間究竟少了什么。
于是,星際大模型把視覺和語言放在同一個(gè)模型中。極視角相關(guān)負(fù)責(zé)人介紹,基于十年AI積累和10億+真實(shí)場(chǎng)景數(shù)據(jù)集自主研發(fā),其可以通過自然語言指令直接定義視覺任務(wù),實(shí)現(xiàn)零樣本、少樣本理解,超過80%的視覺感知場(chǎng)景可以無需重新完成一輪標(biāo)注和訓(xùn)練。
過去是開發(fā)人員先把規(guī)則寫給AI,現(xiàn)在開始變成用戶直接告訴AI“幫我找什么”,比如“找出沒有戴安全帽的人”“看看施工前后少了哪些工具”。視覺AI從固定類別識(shí)別,往開放場(chǎng)景理解邁了一步。
大小模型可以一起工作
大模型出現(xiàn)以后,傳統(tǒng)的小模型并沒有因此“退休”。“大模型與小模型不是替代關(guān)系。”陳碩說。
工廠流水線上,如果只需要識(shí)別一種固定瑕疵,而且要求響應(yīng)快、成本低,小模型仍然更合適。
大模型的優(yōu)勢(shì)體現(xiàn)在另一類場(chǎng)景。比如一架無人機(jī)出去巡檢,沿途可能要同時(shí)尋找?guī)资N、上百種異常,總不能給一架無人機(jī)塞進(jìn)去上百個(gè)獨(dú)立的小模型。這時(shí)候,一個(gè)能夠理解更多目標(biāo)、應(yīng)對(duì)陌生場(chǎng)景的視覺大模型,價(jià)值才真正體現(xiàn)出來。在極視角的方案里,往往是大小模型一起工作。
在某大型鋁業(yè)集團(tuán)的生產(chǎn)現(xiàn)場(chǎng),原料、蒸發(fā)、溶出、分解、焙燒等不同車間,已經(jīng)有50多個(gè)場(chǎng)景應(yīng)用了小模型算法和大模型。高頻、明確、要求快速響應(yīng)的任務(wù)交給小模型,復(fù)雜場(chǎng)景、缺少歷史訓(xùn)練數(shù)據(jù)的問題,再交給星際大模型。一個(gè)擅長“快和準(zhǔn)”,一個(gè)負(fù)責(zé)補(bǔ)上“廣和懂”。
當(dāng)然,大模型自己也在變輕。星際大模型4B版本處理1080P圖像,一般環(huán)境下推理延遲僅1秒出頭。原因并不復(fù)雜:真正到了機(jī)器人、無人機(jī)和邊緣設(shè)備上,參數(shù)不是越大越好,還得考慮算力、速度和部署成本。
產(chǎn)業(yè)現(xiàn)場(chǎng)最終看的,不是誰的模型“個(gè)頭最大”,而是誰真正裝得進(jìn)去、跑得起來。
走向“理解一個(gè)場(chǎng)景”
視覺大模型還有一個(gè)很現(xiàn)實(shí)的問題:它靠什么不斷認(rèn)識(shí)新的東西?
答案仍然是場(chǎng)景。
2021年,極視角把總部從省外遷到青島。陳碩介紹,一個(gè)重要原因,就是人工智能需要和大量實(shí)體場(chǎng)景結(jié)合,而山東工業(yè)體系完整,制造業(yè)、軌道交通等產(chǎn)業(yè)場(chǎng)景,為視覺AI提供了不斷遇到真實(shí)問題的機(jī)會(huì)。
對(duì)于視覺大模型來說,這些場(chǎng)景不只是市場(chǎng),也是它繼續(xù)學(xué)習(xí)的地方。比如,工廠里一條幾公里長的輸送帶,過去出現(xiàn)堵塞、斷裂、冒煙以后,往往要靠人回看監(jiān)控,而現(xiàn)在,視覺AI開始嘗試把事后追溯往事前、事中識(shí)別推進(jìn)。
今天模型認(rèn)識(shí)一個(gè)新的設(shè)備狀態(tài),明天可能又會(huì)遇到一種從未見過的異常。問題不斷出現(xiàn),數(shù)據(jù)不斷積累,模型不斷迭代。“大模型看起來很宏大,但真正落到產(chǎn)業(yè)里,其實(shí)都是由無數(shù)一線的小場(chǎng)景一點(diǎn)點(diǎn)積累出來的。”陳碩說。
這就是視覺大模型的成長方式,機(jī)器的眼睛,并不是訓(xùn)練完成的那一天就算“睜開了”,它還要在無數(shù)個(gè)工廠、地鐵、礦山、城市里繼續(xù)看。看得越多,碰到的問題越多,才可能真正從“識(shí)別一個(gè)物體”,走向“理解一個(gè)場(chǎng)景”。(大眾新聞?dòng)浾?蘇月鵬)
■專家點(diǎn)評(píng)
重塑工業(yè)視覺落地模式緩解行業(yè)痛點(diǎn)
□ 天使投資人、人工智能專家郭濤
極視角Stellaris-VL星際視覺語言大模型重塑了工業(yè)視覺落地模式,顯著緩解了人工標(biāo)注、場(chǎng)景定制的行業(yè)痛點(diǎn)。
依托真實(shí)工業(yè)場(chǎng)景數(shù)據(jù)集與跨模態(tài)架構(gòu),大模型支持自然語言定義視覺任務(wù),憑借零樣本、少樣本能力減少標(biāo)注訓(xùn)練工作量,降低了企業(yè)智能化改造成本。同時(shí)兼顧識(shí)別精度與低幻覺特性,支持云端、邊緣、私有化部署,適配多元算力以及智能制造、軌道交通等場(chǎng)景,依托全鏈路能力推動(dòng)工業(yè)視覺走向標(biāo)準(zhǔn)化復(fù)用。
■記者手記
真正有用的AI“眼睛”在于“讀懂”新題
采訪星際大模型時(shí),記者一直覺得,“沒見過,也能識(shí)別”這件事,比參數(shù)更有意思,因?yàn)檎鎸?shí)世界本來就不是一套固定題庫。
工廠會(huì)換設(shè)備,地鐵里每天有人丟不同的東西,生產(chǎn)線上也總會(huì)出現(xiàn)以前沒碰到過的小概率異常。
傳統(tǒng)視覺AI擅長把一道已知題做到很準(zhǔn)。但大模型正在嘗試解決另一件事:題目變了,它還能不能繼續(xù)答?
這可能也是視覺垂域大模型真正的價(jià)值所在。所謂“垂”,不只是識(shí)別某一個(gè)行業(yè)里的更多物體,而是長期泡在真實(shí)場(chǎng)景里,理解這個(gè)行業(yè)怎么看問題、需要看什么、看到之后又該做什么。
山東擁有大量制造、軌交、礦山等產(chǎn)業(yè)場(chǎng)景,這些場(chǎng)景最大的價(jià)值,不只是給AI提供應(yīng)用市場(chǎng),更重要的在于它們每天都在給模型出新題。
一雙真正有用的AI“眼睛”,恰恰要在這些新題里,越看越懂。
(大眾新聞?dòng)浾?蘇月鵬)